AI Inference là gì? Cách triển khai Suy luận AI
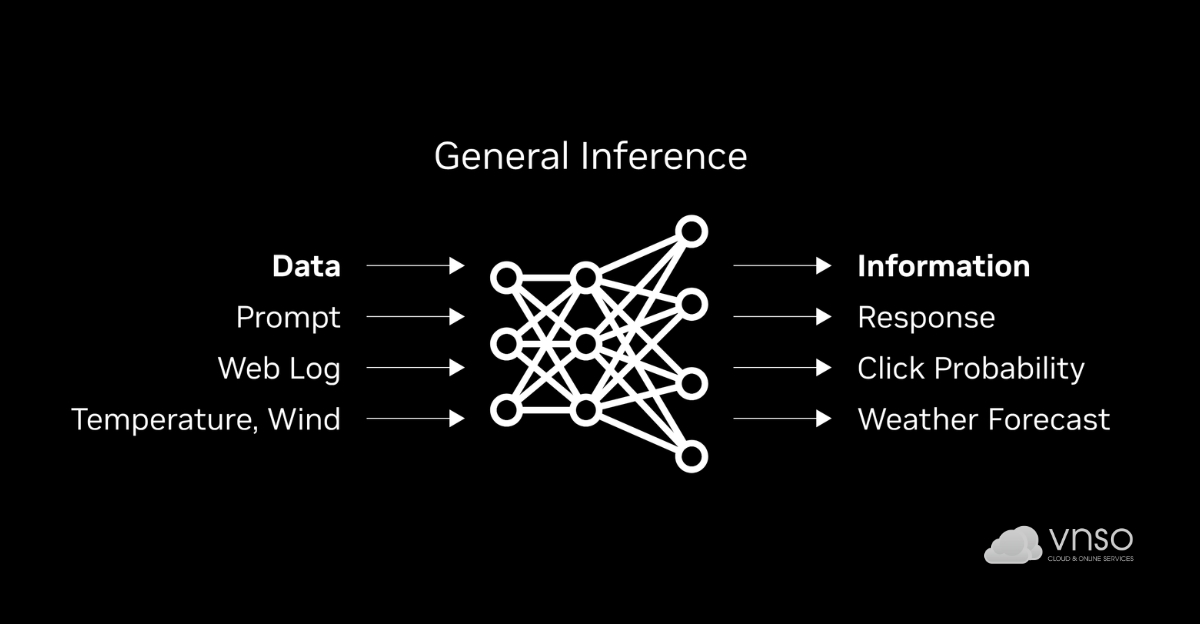
25/09/2026AI Inference (suy luận AI) là quá trình sử dụng một mô hình trí tuệ nhân tạo (AI) đã được huấn luyện để xử lý dữ liệu mới và đưa ra kết quả.
Ví dụ, khi người dùng gửi câu hỏi cho chatbot AI, hệ thống sẽ đưa câu hỏi vào mô hình. Mô hình phân tích dữ liệu đầu vào rồi tạo ra câu trả lời. Đây chính là AI Inference. Nếu AI Training (huấn luyện AI) là quá trình giúp mô hình “học”, AI Inference là quá trình đưa mô hình đó vào sử dụng thực tế.
Khi doanh nghiệp triển khai chatbot, RAG, AI Agent, nhận diện hình ảnh hoặc các ứng dụng Generative AI, Inference trở thành một workload cần được xử lý liên tục. Khi số lượng người dùng và request tăng, yêu cầu về GPU, VRAM, tốc độ xử lý và khả năng mở rộng cũng tăng theo.
AI Inference là gì? Khác gì với AI Training?
AI Training và AI Inference đều sử dụng tài nguyên tính toán để xử lý mô hình. Tuy nhiên, mục đích của hai quá trình hoàn toàn khác nhau. AI Training dùng dữ liệu để huấn luyện mô hình. Trong giai đoạn này, hệ thống liên tục cập nhật các tham số của model để mô hình học được cách xử lý nhiệm vụ.
Sau khi model hoàn tất quá trình huấn luyện, nó có thể được đưa vào AI Inference. Inference không còn tập trung vào việc “dạy” model. Thay vào đó, hệ thống sử dụng model đã có để xử lý dữ liệu mới.
Ví dụ, một doanh nghiệp xây dựng chatbot nội bộ bằng một mô hình ngôn ngữ lớn (Large Language Model – LLM). Quá trình fine-tuning hoặc training model là AI Training. Khi nhân viên gửi câu hỏi và chatbot tạo câu trả lời, đó là AI Inference.
Một số ứng dụng phổ biến của AI Inference gồm chatbot, trợ lý AI, tìm kiếm thông minh, RAG, AI Agent, nhận diện hình ảnh, phân tích video, xử lý giọng nói và các ứng dụng Generative AI.
Điểm khác biệt này cũng ảnh hưởng đến cách xây dựng hạ tầng. Training thường cần lượng tài nguyên tính toán rất lớn trong từng giai đoạn huấn luyện. Inference lại có thể phát sinh liên tục khi ứng dụng được đưa vào vận hành. Vì vậy, một hệ thống Inference cần quan tâm nhiều đến tốc độ phản hồi, số request đồng thời, khả năng mở rộng và chi phí cho mỗi workload.
>>> Xem thêm Hạ tầng AI là gì? Cách triển khai AI hiệu quả doanh nghiệp
AI Inference hoạt động như thế nào trên GPU?
Ở mức cơ bản, quy trình có thể hiểu đơn giản: Dữ liệu đầu vào → Model → GPU xử lý → Kết quả đầu ra
GPU đóng vai trò xử lý các phép tính song song cần thiết để mô hình tạo ra kết quả. Đây là lý do GPU thường được sử dụng cho các workload AI có yêu cầu tính toán cao.Tuy nhiên, lựa chọn GPU cho Inference không chỉ dựa trên việc GPU có mạnh hay không.
VRAM
VRAM là một trong những yếu tố quan trọng nhất.
Model cần được tải vào bộ nhớ GPU để thực thi. Model càng lớn thì nhu cầu bộ nhớ càng cao. Với LLM, GPU còn phải dành bộ nhớ cho KV Cache trong quá trình xử lý request.
Khi có nhiều người dùng cùng gửi yêu cầu, lượng KV Cache cần quản lý cũng có thể tăng. Vì vậy, GPU có đủ VRAM là điều kiện quan trọng để triển khai model ổn định.
GPU Compute
Năng lực tính toán của GPU ảnh hưởng đến tốc độ xử lý model. Tuy nhiên, đây chỉ là một phần của bài toán. Hai GPU có cấu hình khác nhau có thể cho hiệu năng Inference khác nhau tùy model và workload.
Memory Bandwidth
Đặc biệt với LLM, tốc độ di chuyển dữ liệu giữa bộ nhớ GPU và các đơn vị tính toán có ảnh hưởng lớn đến hiệu năng. LLM Inference thường gồm hai giai đoạn chính là Prefill và Decode.
Prefill xử lý toàn bộ prompt đầu vào để tạo trạng thái cần thiết cho quá trình sinh nội dung. Giai đoạn này thiên về khả năng tính toán song song.
Decode tạo ra câu trả lời từng token. Giai đoạn này phụ thuộc nhiều vào tốc độ truy xuất model weights và KV Cache từ bộ nhớ GPU.
Do đó, một GPU phù hợp cho AI Inference cần có sự cân bằng giữa năng lực tính toán, VRAM và memory bandwidth.
Inference Engine
GPU cũng không hoạt động độc lập. Model cần được triển khai thông qua các phần mềm phục vụ Inference. Một số công cụ phổ biến hiện nay gồm vLLM, NVIDIA TensorRT-LLM, NVIDIA Triton Inference Server và SGLang.
Các inference engine có thể hỗ trợ nhiều kỹ thuật tối ưu như batching, quản lý KV Cache, quantization hoặc tối ưu quá trình thực thi model. Vì vậy, hiệu năng Inference thực tế phụ thuộc vào cả GPU + model + inference engine + workload.
>>> Xem thêm NVIDIA T4 Tensor Core GPU – Tối đa suy luận AI Inference
Làm thế nào để tối ưu AI Inference trên GPU?
Khi số lượng request tăng, chỉ bổ sung GPU chưa chắc đã giải quyết toàn bộ vấn đề. Hệ thống cần được tối ưu đồng thời ở cả phần cứng và phần mềm.
Batching
Thay vì xử lý từng request riêng lẻ, hệ thống có thể gom nhiều request để GPU xử lý hiệu quả hơn.
Với LLM, continuous batching cho phép hệ thống liên tục đưa request mới vào khi những request khác hoàn thành. Cách này giúp tận dụng GPU tốt hơn khi có nhiều người dùng đồng thời.
Quantization
Quantization giảm độ chính xác biểu diễn của model, chẳng hạn từ FP16 xuống INT8 hoặc INT4.
Mục tiêu là giảm dung lượng model và nhu cầu bộ nhớ. Trong một số trường hợp, cách này cũng giúp tăng tốc Inference.
Tuy nhiên, quantization có thể tạo ra trade-off về chất lượng. Doanh nghiệp nên benchmark trên chính model và workload thực tế trước khi triển khai production.
KV Cache và PagedAttention
LLM cần lưu trữ KV Cache trong quá trình sinh nội dung. Nếu quản lý bộ nhớ không hiệu quả, VRAM có thể bị sử dụng nhiều và gây giới hạn về số request đồng thời.
Các inference engine hiện đại sử dụng những kỹ thuật như PagedAttention để quản lý KV Cache hiệu quả hơn.
Prefix Caching
Nếu nhiều request sử dụng cùng một phần prompt, hệ thống có thể tái sử dụng kết quả đã xử lý thay vì tính toán lại toàn bộ.
Điều này đặc biệt hữu ích với các ứng dụng có system prompt dài hoặc nhiều request sử dụng chung một context.
Chọn GPU theo workload
Không có một GPU phù hợp cho mọi bài toán. Một model nhỏ dùng để phát triển và thử nghiệm có thể không cần GPU cùng phân khúc với một LLM lớn phục vụ hàng trăm request đồng thời.
Khi lựa chọn GPU, nên xác định trước model, kích thước model, VRAM cần thiết, độ dài context, số người dùng đồng thời, yêu cầu latency và throughput. Nên đặt câu hỏi: GPU nào đáp ứng được workload AI Inference với hiệu năng và chi phí phù hợp?
Triển khai AI Inference trên Cloud GPU như thế nào?
Cloud GPU cung cấp GPU thông qua môi trường cloud. Người dùng có thể tạo máy ảo hoặc instance có GPU, cài đặt môi trường AI và triển khai model mà không cần đầu tư toàn bộ một GPU Server vật lý ngay từ đầu.
Quy trình triển khai có thể gồm các bước sau.
Bước 1: Xác định model
Xác định model sẽ sử dụng. Ví dụ Llama, Qwen, DeepSeek hoặc một model Computer Vision.
Bước 2: Xác định yêu cầu tài nguyên
Kiểm tra kích thước model, yêu cầu VRAM, context length và số request đồng thời.
Bước 3: Chọn GPU
Chọn GPU dựa trên workload thay vì chỉ dựa vào tên sản phẩm. Với model nhỏ hoặc giai đoạn development, có thể sử dụng GPU có VRAM vừa phải. Với model lớn hoặc production workload, có thể cần GPU có VRAM cao hơn hoặc nhiều GPU.
Bước 4: Chuẩn bị môi trường AI
Cài đặt driver, CUDA, framework và inference engine cần thiết. Các framework phổ biến gồm PyTorch và TensorFlow.
Bước 5: Deploy model
Đưa model lên môi trường GPU và khởi chạy inference server. Với LLM, có thể sử dụng các inference engine như vLLM hoặc TensorRT-LLM.
Bước 6: Benchmark
Đo các chỉ số như latency, Time to First Token (TTFT), throughput, tokens per second và GPU utilization.
Bước 7: Tối ưu
Nếu hệ thống chưa đáp ứng yêu cầu, có thể điều chỉnh batch, quantization, KV Cache hoặc inference engine. Trường hợp cần thiết có thể nâng cấp GPU hoặc mở rộng thành nhiều GPU. Cloud GPU đặc biệt phù hợp với giai đoạn phát triển và thử nghiệm AI. Doanh nghiệp có thể thử nhiều cấu hình GPU trước khi quyết định đầu tư GPU Server riêng.
Với workload thay đổi theo thời gian, Cloud GPU cũng giúp doanh nghiệp linh hoạt hơn trong việc phân bổ tài nguyên. Khi workload đã ổn định và sử dụng liên tục, doanh nghiệp có thể cân nhắc GPU Server riêng hoặc mô hình hybrid giữa Cloud GPU và hạ tầng on-premise.
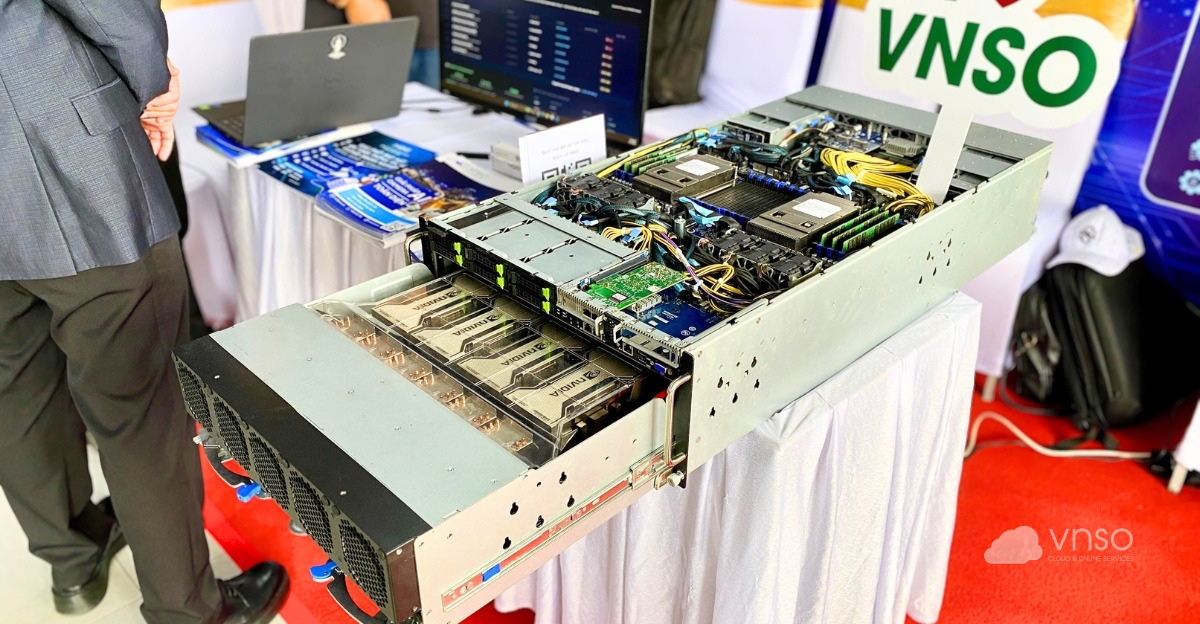
Server GPU NVIDIA A100 tại VNSO
Chọn Hạ tầng GPU hàng đầu cho AI Inference
AI Inference đang trở thành một phần quan trọng trong quá trình đưa AI từ giai đoạn thử nghiệm vào các ứng dụng thực tế.
Theo Gartner, chi tiêu toàn cầu cho AI-optimized IaaS được dự báo đạt khoảng 42,3 tỷ USD trong năm 2026, tăng 96,4%. Đáng chú ý, chi tiêu cho workload Inference được dự báo đạt 23,3 tỷ USD, cao hơn 19 tỷ USD dành cho Training. Điều này cho thấy nhu cầu hạ tầng phục vụ AI Inference đang ngày càng tăng.
Với doanh nghiệp và đội ngũ AI/Dev, Cloud GPU là một lựa chọn để bắt đầu triển khai Inference mà không cần đầu tư ngay một hệ thống GPU Server riêng.
VNSO cung cấp Cloud GPU với nhiều cấu hình GPU, hỗ trợ thuê theo giờ hoặc theo tháng. Người dùng có thể lựa chọn tài nguyên dựa trên nhu cầu thực tế và triển khai môi trường AI cho các workload như LLM, RAG, Computer Vision và Generative AI.
Môi trường Cloud GPU VNSO hỗ trợ các công cụ và framework phổ biến như CUDA, cuDNN, Python, PyTorch, TensorFlow và OpenCV, giúp rút ngắn thời gian chuẩn bị môi trường.
Tùy workload, doanh nghiệp có thể bắt đầu từ một GPU để development và testing, sau đó benchmark và nâng cấp tài nguyên khi đưa ứng dụng vào vận hành.
Bạn đang cần GPU để chạy LLM, RAG, AI Agent hoặc các mô hình AI khác?
>>> Tham khảo Cloud GPU VNSO để lựa chọn cấu hình GPU phù hợp với workload và bắt đầu triển khai AI Inference.
Các câu hỏi thường gặp về AI Inference (FAQ)
1. AI Inference có cần Internet để hoạt động không?
Không nhất thiết. Sau khi model và các thành phần cần thiết đã được triển khai trên GPU Server hoặc Cloud GPU, hệ thống có thể xử lý inference trong môi trường riêng. Internet chủ yếu cần cho việc tải model, cập nhật phần mềm hoặc kết nối ứng dụng với inference server.
2. Có thể chạy nhiều mô hình AI trên cùng một GPU không?
Có. Một GPU có thể phục vụ nhiều model nếu tài nguyên đáp ứng đủ. Inference server như NVIDIA Triton hỗ trợ chạy đồng thời nhiều model trên cùng GPU và quản lý việc phân bổ tài nguyên.
3. Tại sao request đầu tiên đôi khi chậm hơn những request sau?
Đây có thể là hiện tượng cold start hoặc model warm-up. Khi khởi động, hệ thống có thể phải tải model, khởi tạo framework, CUDA và bộ nhớ cần thiết trước khi xử lý ổn định. Vì vậy, inference server thường có cơ chế warm-up để giảm độ trễ ban đầu.
4. Có cần CPU và RAM khi chạy AI Inference trên GPU không?
Có. GPU đảm nhiệm phần lớn phép tính AI, nhưng CPU và RAM vẫn được sử dụng cho API, preprocessing, quản lý request, dữ liệu và các thành phần của inference server. Cấu hình GPU không nên được xem xét tách biệt khỏi toàn bộ hệ thống.
5. Làm sao biết GPU đang được sử dụng hiệu quả khi chạy Inference?
Có thể theo dõi GPU utilization, VRAM, queue size, số request đồng thời, throughput và latency. Với LLM, có thể theo dõi thêm TTFT, token latency và KV Cache để xác định điểm nghẽn của hệ thống.
6. AI Inference có thể tự động tăng GPU khi lượng người dùng tăng không?
Có, nếu hạ tầng được thiết kế để autoscaling. Hệ thống có thể tạo thêm các inference instance khi lượng request tăng và giảm tài nguyên khi nhu cầu giảm. Tuy nhiên, quá trình scale có thể mất thời gian do phải khởi tạo máy, container và tải model.
7. Có thể dùng một GPU Server để vừa chạy nhiều model vừa phục vụ API không?
Có. Inference server có thể quản lý nhiều model và nhận request thông qua API. Cách triển khai này phù hợp khi các model có nhu cầu tài nguyên vừa phải và có thể chia sẻ cùng một hệ thống GPU.
8. Có cần benchmark trước khi đưa AI Inference vào sử dụng thực tế không?
Nên có. Benchmark giúp xác định hệ thống đáp ứng được bao nhiêu request, độ trễ thực tế và mức sử dụng tài nguyên trước khi production. NVIDIA Triton cũng cung cấp công cụ đo hiệu năng để đánh giá mối quan hệ giữa latency và throughput.
9. Model AI có thể cập nhật mà không cần dừng toàn bộ hệ thống không?
Có thể, tùy kiến trúc serving. Một số inference server hỗ trợ quản lý việc load và unload model trong lúc hệ thống đang hoạt động, giúp triển khai hoặc thay đổi model linh hoạt hơn.
10. AI Inference có cần GPU chạy liên tục 24/7 không?
Không phải mọi workload đều cần. Nếu ứng dụng chỉ phát sinh request theo từng thời điểm, có thể sử dụng mô hình tài nguyên linh hoạt hoặc khởi tạo GPU theo nhu cầu. Với dịch vụ cần phản hồi liên tục, GPU thường phải được duy trì sẵn để giảm thời gian chờ khởi động.
Thông tin liên hệ
Để tìm hiểu thông tin về các giải pháp CNTT, Cloud Server, GPU và màn hình LED BOE hàng đầu Việt Nam, Quý khách vui lòng liên hệ chúng tôi theo thông tin dưới đây:
CÔNG TY CỔ PHẦN CÔNG NGHỆ VNSO – SINCE 2015
– Website: https://vnso.vn/
– Fanpage: Facebook | LinkedIn | YouTube | TikTok
– Hotline: 0927 444 222 | Email: info@vnso.vn
– Trụ sở: Lô O số 10, Đường số 15, KDC Miếu Nổi, Phường Gia Định, TP. Hồ Chí Minh
– VPGD Đà Nẵng: 30 Nguyễn Hữu Thọ, Phường Hải Châu, Đà Nẵng
– VPGD Hà Nội: 132 Vũ Phạm Hàm, Phường Yên Hòa, Hà Nội