Thuê GPU chạy AI thì nên thuê GPU nào?
04/11/2026Thuê GPU chạy AI thì nên chọn RTX 3090, A4000, A5000 hay A100? Không phải GPU có VRAM lớn nhất luôn là lựa chọn tốt nhất để chạy AI. Mỗi dòng GPU có hiệu năng, dung lượng bộ nhớ và mức chi phí khác nhau. Chọn đúng cấu hình giúp mô hình vận hành ổn định và tối ưu ngân sách.
Vậy cần bao nhiêu VRAM để chạy LLM, AI Training hoặc tạo ảnh bằng AI? Bài viết dưới đây sẽ giúp bạn xác định cấu hình phù hợp theo từng nhu cầu sử dụng.
Thuê GPU chạy AI là gì?
Thuê GPU chạy AI là hình thức sử dụng sức mạnh xử lý của card đồ họa (GPU) thông qua Internet, thay vì phải mua và lắp đặt GPU trực tiếp trên máy tính cá nhân hoặc máy chủ riêng. GPU được đặt tại trung tâm dữ liệu của nhà cung cấp, cho phép người dùng kết nối từ xa để thực hiện các tác vụ như huấn luyện mô hình AI (Training), suy luận (Inference), chạy LLM hoặc tạo hình ảnh bằng AI.
Tùy nhu cầu, người dùng có thể thuê GPU theo giờ hoặc theo tháng, lựa chọn cấu hình phù hợp với dung lượng VRAM và hiệu năng cần thiết. Hình thức này giúp tiếp cận các dòng GPU mạnh như RTX 3090, A5000 hay A100 mà không cần đầu tư chi phí lớn để sở hữu phần cứng.
Những yếu tố cần biết trước khi chọn GPU chạy AI
Trước khi lựa chọn GPU, người dùng cần xác định mô hình AI sẽ triển khai và khối lượng công việc dự kiến. Một cấu hình phù hợp cần đáp ứng cả yêu cầu về bộ nhớ, hiệu năng tính toán và khả năng tương thích phần mềm.
VRAM – yếu tố quan trọng khi chạy mô hình AI
VRAM là bộ nhớ riêng của GPU, dùng để lưu trữ trọng số mô hình, dữ liệu và các thông tin trung gian trong quá trình tính toán. Nếu mô hình cần nhiều bộ nhớ hơn dung lượng VRAM khả dụng, chương trình có thể gặp lỗi thiếu bộ nhớ hoặc phải sử dụng phương án phân bổ tài nguyên khác làm giảm hiệu năng.
Dung lượng VRAM cần thiết phụ thuộc vào kích thước mô hình, độ chính xác số học, batch size và độ dài ngữ cảnh. Vì vậy, không nên chỉ dựa vào tên GPU hoặc số nhân CUDA để lựa chọn.
Cách ước tính VRAM theo kích thước mô hình
Với mô hình có 7 tỷ tham số (7B), riêng phần trọng số có thể cần khoảng 14GB khi sử dụng FP16. Nếu lượng tử hóa xuống INT8, phần trọng số có thể cần khoảng 7GB; với INT4, con số lý thuyết còn khoảng 3,5GB.
Đây chỉ là mức ước tính cho trọng số, chưa bao gồm bộ nhớ dành cho KV Cache, dữ liệu đầu vào, activation và các thành phần khác. Khi Fine-tuning hoặc Training, nhu cầu bộ nhớ thường cao hơn đáng kể so với chỉ chạy Inference.
| Định dạng | Bộ nhớ lý thuyết cho mỗi tham số | Ví dụ mô hình 7B |
|---|---|---|
| FP32 | 4 byte | Khoảng 28GB |
| FP16/BF16 | 2 byte | Khoảng 14GB |
| INT8 | 1 byte | Khoảng 7GB |
| INT4 | 0,5 byte | Khoảng 3,5GB |
CUDA Cores và Tensor Cores
CUDA Cores đảm nhiệm nhiều phép tính song song trong GPU. Tensor Cores được tối ưu cho các phép toán ma trận thường xuất hiện trong AI và Deep Learning.
Tuy nhiên, số lượng nhân không quyết định toàn bộ tốc độ xử lý. Kiến trúc GPU, băng thông bộ nhớ, độ chính xác tính toán và khả năng tối ưu của phần mềm cũng ảnh hưởng đến hiệu năng thực tế.
Phân biệt AI Training và AI Inference
AI Training là quá trình huấn luyện mô hình từ dữ liệu, thường cần nhiều tài nguyên tính toán và bộ nhớ. Fine-tuning cũng cần GPU đủ mạnh để cập nhật một phần hoặc toàn bộ trọng số mô hình.
Trong khi đó, AI Inference là quá trình sử dụng mô hình đã huấn luyện để tạo kết quả dự đoán hoặc phản hồi. Nhu cầu VRAM thường thấp hơn Training, nhưng có thể tăng đáng kể khi xử lý nhiều yêu cầu đồng thời hoặc sử dụng context dài.
>>> Xem thêm Hướng dẫn thuê GPU Train AI nhanh chóng, dễ dàng
Nên thuê GPU nào cho từng nhu cầu chạy AI?
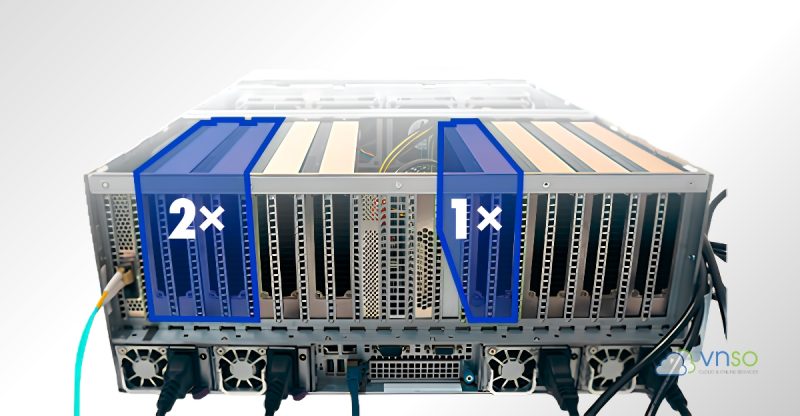
Không có một GPU phù hợp với tất cả dự án. Người mới có thể bắt đầu bằng cấu hình tầm trung để thử nghiệm, sau đó nâng cấp khi mô hình hoặc khối lượng công việc tăng lên.
NVIDIA RTX A4000 16GB – Phù hợp thử nghiệm và phát triển AI
RTX A4000 có 16GB GDDR6 ECC, kiến trúc Ampere, 6.144 CUDA Cores và 192 Tensor Cores thế hệ thứ ba. Đây là lựa chọn phù hợp cho lập trình viên cần môi trường GPU để học CUDA, phát triển ứng dụng AI, xử lý ảnh và thử nghiệm mô hình có quy mô vừa phải.
Với 16GB VRAM, GPU có thể chạy nhiều mô hình nhỏ, một số mô hình LLM đã lượng tử hóa và các tác vụ Inference phù hợp. Tuy nhiên, dung lượng này có thể hạn chế khi chạy mô hình lớn, context dài hoặc nhiều tác vụ cùng lúc.
NVIDIA RTX 3090 24GB – Phù hợp Deep Learning và Generative AI
RTX 3090 sở hữu 24GB GDDR6X VRAM, cung cấp không gian bộ nhớ lớn hơn so với nhóm GPU 16GB. Dung lượng này hữu ích khi thử nghiệm Deep Learning, Computer Vision, tạo ảnh bằng Stable Diffusion và chạy các mô hình LLM đã tối ưu bộ nhớ.
RTX 3090 là lựa chọn đáng cân nhắc cho cá nhân, nhà phát triển và nhóm nghiên cứu cần GPU có VRAM tương đối lớn. Khi triển khai Training hoặc Inference, hiệu năng vẫn phụ thuộc vào phiên bản mô hình, batch size và phần mềm sử dụng.
NVIDIA RTX A5000 24GB – Phù hợp phát triển AI và workstation chuyên nghiệp
RTX A5000 có 24GB GDDR6 ECC, 8.192 CUDA Cores và 256 Tensor Cores thế hệ thứ ba. GPU sử dụng kiến trúc Ampere, hướng đến các tác vụ đồ họa chuyên nghiệp, tính toán tăng tốc và ứng dụng AI.
Đây là lựa chọn phù hợp cho nhóm phát triển cần môi trường GPU ổn định để thử nghiệm mô hình, xử lý dữ liệu và chạy Inference. So với A4000, A5000 có thêm VRAM và năng lực tính toán cao hơn, phù hợp với workload nặng hơn trong cùng nhóm GPU workstation.
NVIDIA A100 40GB/80GB – Phù hợp AI Training và mô hình lớn
A100 là GPU trung tâm dữ liệu thuộc kiến trúc Ampere, được thiết kế cho các workload tính toán hiệu năng cao. Phiên bản 40GB hoặc 80GB HBM2e cung cấp dung lượng bộ nhớ lớn và băng thông cao, phù hợp với Training, Fine-tuning và Inference trên các mô hình có yêu cầu tài nguyên lớn.
A100 40GB có thể đáp ứng nhiều workload AI chuyên sâu mà GPU 16GB hoặc 24GB khó xử lý. Phiên bản 80GB phù hợp hơn khi cần chạy mô hình lớn, batch size cao hoặc giảm nhu cầu chia mô hình qua nhiều GPU.
NVIDIA H100 và H200 – Dành cho AI quy mô lớn
H100 thuộc kiến trúc Hopper, được thiết kế cho AI Training và Inference hiệu năng cao. Phiên bản H100 SXM có 80GB HBM3, trong khi H100 NVL có 94GB bộ nhớ GPU theo thông số NVIDIA.
H200 tiếp tục nâng cấp dung lượng bộ nhớ lên 141GB HBM3e, cùng băng thông bộ nhớ cao. Đây là nhóm GPU phù hợp với doanh nghiệp, trung tâm nghiên cứu và hệ thống cần triển khai LLM quy mô lớn hoặc xử lý nhiều workload AI chuyên sâu.
| GPU | VRAM tham khảo | Nhu cầu phù hợp |
|---|---|---|
| RTX A4000 | 16GB | Học AI, thử nghiệm, Computer Vision |
| RTX 3090 | 24GB | Deep Learning, Generative AI, LLM lượng tử hóa |
| RTX A5000 | 24GB | Phát triển AI, Inference, workstation |
| A100 | 40GB / 80GB | Training, Fine-tuning, LLM |
| H100 | 80GB / 94GB | AI Training và Inference quy mô lớn |
| H200 | 141GB | LLM lớn, AI và HPC chuyên sâu |
Thông số có thể khác nhau theo phiên bản PCIe, SXM hoặc cấu hình máy chủ. Khả năng chạy mô hình thực tế còn phụ thuộc vào framework, phương pháp lượng tử hóa và bộ nhớ hệ thống.
Chọn GPU theo mô hình và ứng dụng AI thực tế
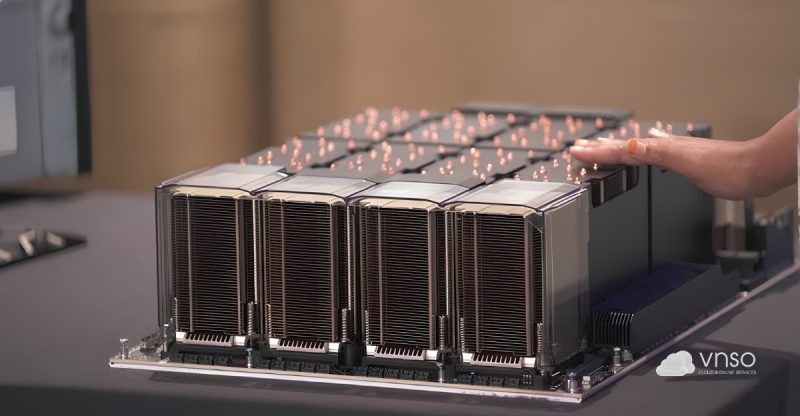
Ngoài dung lượng VRAM, người dùng nên lựa chọn GPU dựa trên loại mô hình và tác vụ cần triển khai. Cùng một GPU có thể hoạt động tốt với Inference nhưng không đủ tài nguyên cho Training.
Chạy LLM và chatbot AI
Các mô hình ngôn ngữ lớn như Llama hoặc những mô hình mã nguồn mở khác có thể yêu cầu dung lượng VRAM đáng kể. Mô hình 7B ở FP16 cần khoảng 14GB chỉ cho phần trọng số, chưa tính bộ nhớ phát sinh trong quá trình vận hành.
Với mô hình nhỏ đã lượng tử hóa, GPU 16GB hoặc 24GB có thể đáp ứng một số nhu cầu thử nghiệm và Inference. Nếu cần context dài, nhiều người dùng đồng thời hoặc mô hình có kích thước lớn hơn, nên cân nhắc A100 40GB/80GB hoặc GPU có VRAM cao hơn.
Chạy Stable Diffusion và Generative AI
Các công cụ tạo ảnh bằng AI như Stable Diffusion sử dụng GPU để xử lý quá trình sinh ảnh. Dung lượng VRAM cần thiết phụ thuộc vào phiên bản mô hình, độ phân giải, batch size và các tiện ích mở rộng.
RTX 3090 24GB hoặc RTX A5000 24GB là những lựa chọn đáng cân nhắc cho nhu cầu tạo ảnh và thử nghiệm Generative AI. RTX A4000 16GB vẫn có thể đáp ứng nhiều workflow phù hợp, đặc biệt khi tối ưu độ phân giải và thiết lập bộ nhớ.
AI Training và Fine-tuning
Training mô hình từ đầu thường cần tài nguyên lớn hơn nhiều so với Inference. Ngoài trọng số, GPU còn phải lưu gradient, activation và trạng thái optimizer trong quá trình cập nhật mô hình.
Với các bài toán nhỏ hoặc thử nghiệm, RTX 3090 và A5000 có thể là lựa chọn khởi đầu. Khi cần Fine-tuning mô hình lớn, tăng batch size hoặc huấn luyện chuyên sâu, A100 40GB/80GB sẽ phù hợp hơn.
Computer Vision và xử lý video
Các ứng dụng nhận diện hình ảnh, phân loại đối tượng, phân tích camera và xử lý video có nhu cầu GPU khác nhau tùy theo độ phân giải và số luồng dữ liệu. Những dự án thử nghiệm hoặc triển khai ở quy mô nhỏ có thể bắt đầu với A4000 hoặc RTX 3090.
Khi cần xử lý nhiều luồng video, mô hình phức tạp hoặc Training trên tập dữ liệu lớn, nên cân nhắc GPU có VRAM và năng lực tính toán cao hơn. Ngoài GPU, CPU, RAM và tốc độ lưu trữ cũng ảnh hưởng đến toàn bộ pipeline xử lý.
>>> Xem thêm Thuê Cloud Gaming – Cách chơi Game cấu hình cao, chi phí thấp
Thuê GPU theo giờ hay theo tháng? Cách chọn cấu hình tối ưu
Sau khi xác định dòng GPU, người dùng cần lựa chọn thời gian thuê và tài nguyên hệ thống đi kèm. Một cấu hình phù hợp không chỉ cần đủ VRAM mà còn phải đáp ứng CPU, RAM, lưu trữ và thời lượng sử dụng.
Khi nào nên thuê GPU theo giờ?
Thuê theo giờ phù hợp với người mới học AI, lập trình viên đang thử nghiệm mô hình hoặc nhóm phát triển có workload không liên tục. Người dùng chỉ cần trả phí theo thời gian sử dụng, thay vì đầu tư máy chủ GPU ngay từ đầu.
Ví dụ, nếu chỉ cần chạy thử một mô hình, kiểm tra thư viện hoặc thực hiện một tác vụ Inference trong vài giờ, thuê theo giờ giúp kiểm soát ngân sách tốt hơn. Đây cũng là cách đánh giá hiệu năng thực tế trước khi chọn cấu hình dài hạn.
Khi nào nên thuê GPU theo tháng?
Thuê theo tháng phù hợp với dự án sử dụng GPU thường xuyên, môi trường phát triển cần duy trì liên tục hoặc workload chạy trong thời gian dài. Khi thời lượng sử dụng cao, hình thức này có thể giúp tối ưu chi phí so với thuê theo giờ.
Người dùng nên so sánh tổng chi phí dự kiến theo số giờ sử dụng thực tế. Cần tính cả thời gian máy chạy thử nghiệm, Training, Inference và thời gian duy trì môi trường.
Cấu hình nào phù hợp với từng ngân sách?
Có thể tham khảo cách phân nhóm dưới đây để xác định điểm bắt đầu:
| Nhu cầu | GPU nên cân nhắc | Định hướng lựa chọn |
|---|---|---|
| Học AI, lập trình CUDA | RTX A4000 16GB | Thử nghiệm và phát triển cơ bản |
| Chạy mô hình AI, tạo ảnh | RTX 3090 24GB | Cần VRAM lớn hơn cho Generative AI |
| Phát triển AI chuyên sâu | RTX A5000 24GB | Workstation và Inference |
| Fine-tuning, LLM lớn | A100 40GB/80GB | Ưu tiên VRAM và băng thông |
| AI Training quy mô lớn | H100/H200 | Workload chuyên sâu, yêu cầu hiệu năng cao |
Những thông số cần kiểm tra trước khi thuê GPU chạy AI
- VRAM: Đủ để chứa mô hình, dữ liệu và bộ nhớ phát sinh.
- CPU và RAM: Đáp ứng việc xử lý dữ liệu, tiền xử lý và điều phối tác vụ.
- Ổ cứng: Đủ dung lượng lưu mô hình, dataset, checkpoint và kết quả.
- CUDA và framework: Tương thích với phiên bản PyTorch, TensorFlow hoặc thư viện đang sử dụng.
- Hệ điều hành: Phù hợp với môi trường phát triển và công cụ triển khai.
- Thời gian thuê: Chọn theo giờ hoặc tháng dựa trên tần suất sử dụng thực tế.
Một điểm cần lưu ý là GPU mạnh không thể bù đắp hoàn toàn cho CPU, RAM hoặc ổ cứng thiếu tài nguyên. Với dự án xử lý dữ liệu lớn, cần đánh giá tổng thể cấu hình máy chủ thay vì chỉ tập trung vào card đồ họa.
Thuê Cloud GPU chạy AI linh hoạt tại VNSO
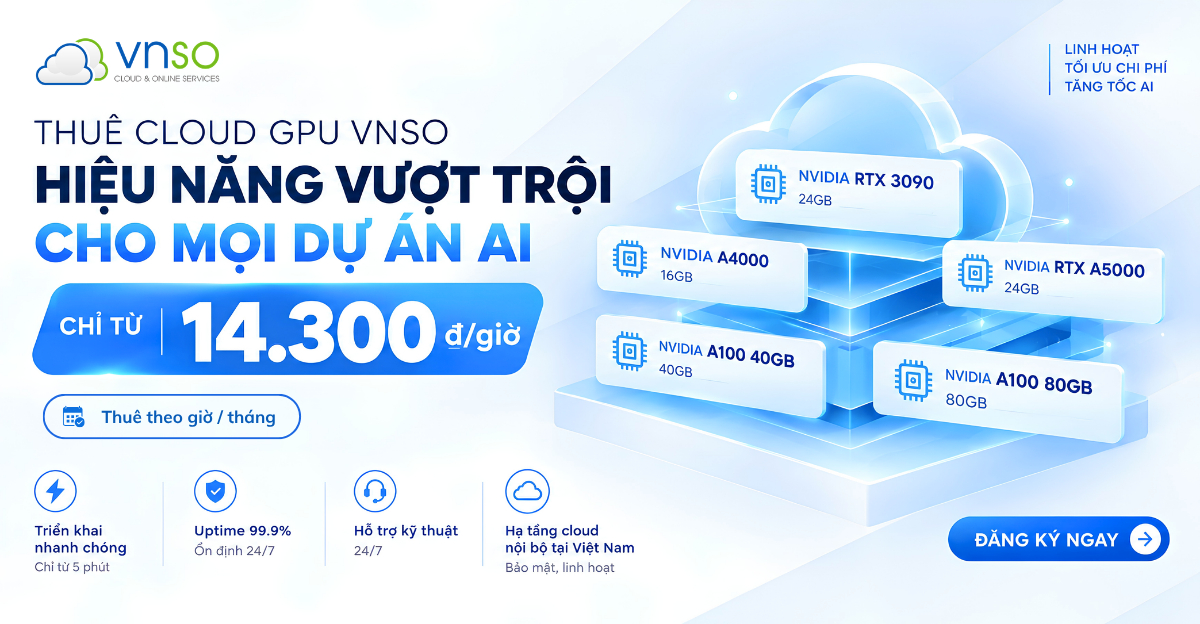
VNSO cung cấp dịch vụ Cloud GPU với nhiều lựa chọn cấu hình, phục vụ nhu cầu từ thử nghiệm mô hình đến phát triển và triển khai ứng dụng AI. Người dùng có thể lựa chọn GPU như RTX A4000, RTX 3090, RTX A5000 và A100 theo nhu cầu tính toán.
Dịch vụ hỗ trợ thuê linh hoạt theo giờ hoặc theo tháng, giúp cá nhân và doanh nghiệp chủ động ngân sách. Môi trường Cloud GPU được định hướng thuận tiện cho việc triển khai AI với các framework và công cụ cần thiết.
Một số tiện ích nổi bật gồm khởi tạo GPU nhanh, môi trường AI được cài đặt sẵn, Snapshot để lưu và khôi phục môi trường, cùng chính sách giữ dữ liệu tối đa 72 giờ miễn phí khi dừng máy theo điều kiện dịch vụ. VNSO cũng hỗ trợ kỹ thuật 24/7 trong quá trình sử dụng.
Với mức giá trải nghiệm từ 14.300đ/giờ cho cấu hình áp dụng, người dùng có thể bắt đầu thử nghiệm AI mà không cần đầu tư hệ thống GPU vật lý.
>>> Cần tư vấn, triển khai và báo giá? Liên hệ ngay VNSO bên dưới!
Câu hỏi thường gặp khi thuê GPU chạy AI (FAQ)
1. Có thể thuê GPU chạy AI mà không cần biết lập trình không?
Có. Người dùng có thể sử dụng các giao diện AI có sẵn như Jupyter Notebook, ComfyUI hoặc các công cụ triển khai mô hình trực quan mà không cần tự xây dựng toàn bộ chương trình. Tuy nhiên, vẫn cần biết một số thao tác cơ bản như kết nối máy chủ, cài đặt thư viện và quản lý dữ liệu.
2. Thuê GPU chạy AI có cần cài đặt CUDA không?
CUDA là nền tảng của NVIDIA giúp các ứng dụng tận dụng khả năng tính toán song song trên GPU. Một số dịch vụ Cloud GPU đã chuẩn bị sẵn CUDA, cuDNN và các thư viện AI phổ biến, giúp người dùng giảm thời gian thiết lập môi trường.
Nếu tự cài đặt, cần chọn phiên bản CUDA tương thích với driver NVIDIA và framework đang sử dụng. Cài đặt sai phiên bản có thể khiến PyTorch hoặc TensorFlow không nhận GPU.
3. Có thể chạy nhiều mô hình AI cùng lúc trên một GPU không?
Có, nếu GPU còn đủ tài nguyên bộ nhớ và năng lực tính toán. Tuy nhiên, nhiều mô hình cùng hoạt động sẽ chia sẻ tài nguyên GPU, có thể làm giảm tốc độ xử lý hoặc gây lỗi thiếu VRAM.
Với hệ thống trung tâm dữ liệu hỗ trợ NVIDIA Multi-Instance GPU (MIG), một số GPU có thể được chia thành các phiên bản GPU độc lập với tài nguyên tính toán và bộ nhớ riêng. Tính năng này phụ thuộc vào dòng GPU và cách nhà cung cấp triển khai.
4. Khi thuê GPU chạy AI, có thể kết nối từ máy tính cá nhân để làm việc không?
Có. Người dùng thường kết nối Cloud GPU thông qua SSH, giao diện trình duyệt hoặc công cụ quản lý từ xa do nhà cung cấp hỗ trợ.
Nhờ đó, máy tính cá nhân chỉ cần đảm nhiệm việc điều khiển và hiển thị kết quả. Các tác vụ tính toán AI được thực hiện trên máy chủ Cloud GPU.
5. Nếu ngắt kết nối Internet, mô hình AI đang chạy có bị dừng không?
Không nhất thiết. Nếu tác vụ được chạy trong một phiên làm việc độc lập trên máy chủ, chẳng hạn thông qua tmux, screen hoặc dịch vụ nền, chương trình vẫn có thể tiếp tục hoạt động khi máy tính cá nhân mất kết nối.
Ngược lại, nếu chương trình phụ thuộc trực tiếp vào phiên terminal hoặc notebook đang mở, việc ngắt kết nối có thể ảnh hưởng đến quá trình thực thi. Người dùng nên thiết lập phiên chạy nền và cơ chế lưu checkpoint cho các tác vụ dài.
6. Có thể chuyển mô hình AI và dữ liệu từ máy tính cá nhân lên Cloud GPU không?
Có. Người dùng có thể tải dữ liệu và mô hình lên máy chủ thông qua SSH, SFTP, SCP hoặc các nền tảng lưu trữ tương thích.
Với dataset lớn, nên chuẩn bị trước dung lượng lưu trữ và phương thức truyền dữ liệu phù hợp. Việc chuyển dữ liệu qua Internet có thể mất nhiều thời gian tùy vào kích thước tệp và tốc độ đường truyền.
7. Làm thế nào để giảm chi phí khi chạy AI trên Cloud GPU?
Có thể tối ưu chi phí bằng cách giải phóng GPU khi không sử dụng, lựa chọn batch size phù hợp và sử dụng mô hình đã lượng tử hóa nếu workload cho phép. Với các tác vụ Training kéo dài, nên lưu checkpoint định kỳ để hạn chế việc phải chạy lại từ đầu khi có sự cố.
Ngoài ra, nên đo thời gian sử dụng thực tế trước khi quyết định thuê theo giờ hay theo tháng. Điều này giúp lựa chọn gói dịch vụ phù hợp với tần suất làm việc.
8. Có thể sử dụng một GPU cho nhiều người trong nhóm cùng lúc không?
Có thể, tùy vào cách nhà cung cấp cấp phát GPU và cấu hình máy chủ. Nhiều người có thể truy cập cùng một máy chủ, nhưng cần phân quyền tài khoản, quản lý tiến trình và phân bổ tài nguyên để tránh ảnh hưởng lẫn nhau.
Nếu cần cách ly tài nguyên rõ ràng, doanh nghiệp có thể cân nhắc GPU hỗ trợ MIG hoặc hệ thống cấp phát GPU riêng cho từng người dùng.
9. Vì sao GPU có VRAM lớn nhưng tốc độ chạy AI vẫn chưa nhanh?
VRAM lớn chủ yếu giúp GPU chứa được mô hình và dữ liệu có kích thước lớn hơn. Tốc độ xử lý còn phụ thuộc vào kiến trúc GPU, băng thông bộ nhớ, năng lực tính toán, CPU và cách tối ưu phần mềm.
Với LLM, tốc độ sinh token còn chịu ảnh hưởng đáng kể từ độ dài context, số lượng yêu cầu đồng thời và phương pháp triển khai mô hình. Vì vậy, dung lượng VRAM không phải chỉ số duy nhất để đánh giá hiệu năng.
10. Có nên thuê nhiều GPU nhỏ thay vì một GPU VRAM lớn không?
Điều này phụ thuộc vào khả năng phân tán workload của mô hình và phần mềm. Một số framework hỗ trợ chia mô hình hoặc dữ liệu trên nhiều GPU, nhưng việc triển khai cần thêm bộ nhớ trao đổi và kết nối tốc độ cao giữa các GPU.
Nếu mô hình không hỗ trợ phân tán hiệu quả, một GPU có VRAM đủ lớn có thể đơn giản và thuận tiện hơn. Nên kiểm tra khả năng Multi-GPU của framework trước khi lựa chọn cấu hình.
Thông tin liên hệ thuê GPU chạy AI
Để tìm hiểu thông tin về các giải pháp CNTT, Cloud Server, GPU và màn hình LED BOE hàng đầu Việt Nam, Quý khách vui lòng liên hệ chúng tôi theo thông tin dưới đây:
CÔNG TY CỔ PHẦN CÔNG NGHỆ VNSO – SINCE 2015
– Website: https://vnso.vn/
– Fanpage: Facebook | LinkedIn | YouTube | TikTok
– Hotline: 0927 444 222 | Email: info@vnso.vn
– Trụ sở: Lô O số 10, Đường số 15, KDC Miếu Nổi, Phường Gia Định, TP. Hồ Chí Minh
– VPGD Đà Nẵng: 30 Nguyễn Hữu Thọ, Phường Hải Châu, Đà Nẵng
– VPGD Hà Nội: 132 Vũ Phạm Hàm, Phường Yên Hòa, Hà Nội